Szkolenie Jak działa LLM
Zbudujesz od zera mały model językowy i zrozumiesz, na jakiej zasadzie działają ChatGPT i Claude.
Zapytaj o termin Pobierz program (PDF)Duże modele językowe wyglądają jak magia, dopóki nie zbudujesz własnego. Na tym szkoleniu krok po kroku piszesz mały model językowy, który uczy się na tekście i generuje nowy. Każdy element dodajesz sam, więc wiesz, po co istnieje i co się stanie, gdy go zabraknie. Model jest na tyle mały, że trenujesz go na zwykłym laptopie, bez osobnej karty graficznej. PyTorch poznasz na miejscu, nie musisz go znać wcześniej. Dostaniesz szkielet projektu, więc skupiasz się na modelu, a nie na konfiguracji.
Dzięki temu lepiej ocenisz możliwości i ograniczenia AI w swoim projekcie: zrozumiesz, skąd biorą się halucynacje, czym jest okno kontekstu i dlaczego ten sam prompt daje różne odpowiedzi.
Program
3 dni
- Od tekstu do liczb
- Tokenizacja: znaki, słowa i Byte Pair Encoding
- Słownik i zamiana tekstu na tensory w PyTorch
- Zbiór treningowy i walidacyjny
- Model bigramowy
- Przewidywanie następnego tokenu na podstawie poprzedniego
- Rozkład prawdopodobieństwa i funkcja softmax
- Pierwsze generowanie tekstu
- Trening
- Funkcja straty: entropia krzyżowa
- Gradient, propagacja wsteczna i optymalizator AdamW
- Pętla treningowa, rozmiar batcha i tempo uczenia (learning rate)
- Przeuczenie i jak je rozpoznać
- Embeddingi
- Wektory tokenów i pozycji
- Podobieństwo słów na gotowych embeddingach z Hugging Face
- Mechanizm uwagi
- Self-attention: zapytania, klucze i wartości
- Maska przyczynowa: model nie widzi przyszłości
- Skalowanie iloczynu skalarnego (scaled dot-product) i dropout
- Multi-head attention
- Blok transformera
- Warstwa feed-forward, połączenia rezydualne i LayerNorm
- Składanie bloków w pełny model
- Liczba parametrów a jakość wyników
- Co zmieniło się od GPT-2: RoPE, RMSNorm, SwiGLU i grouped-query attention
- Generowanie tekstu
- Temperatura, top-k i top-p
- KV cache: dlaczego generowanie przyspiesza
- Okno kontekstu i jego ograniczenia
- Dlaczego modele halucynują
- Od mini-modelu do prawdziwego LLM
- Pretrening na ogromnych zbiorach danych
- Fine-tuning i modele instrukcyjne
- RLHF i DPO: dopasowanie modelu do oczekiwań ludzi
- Modele z rozumowaniem i uczenie ze wzmocnieniem
- Mixture of experts: duży model, który liczy tylko część wag
- Otwarte modele na Twoim komputerze
- Kwantyzacja: mniejsze wagi, mniej pamięci
- Ćwiczenie: skwantyzowany otwarty model na Twoim laptopie
- Co z tego wynika w praktyce
- Jak pisać prompty, znając budowę modelu
- Dlaczego model myli się w liczeniu liter (tokenizacja) i arytmetyce
- Jak ocenić obietnice dostawcy: rozmiar kontekstu, liczba parametrów
- Koszty: tokeny, rozmiar modelu i sprzęt
Dla kogo?
- Dla programistów, którzy chcą rozumieć modele, a nie tylko wołać ich API.
- Dla osób, które planują budować produkty oparte na modelach językowych.
- Dla programistów w zespołach, które oceniają ryzyko i ograniczenia AI w projekcie.
Co musisz umieć?
- Swobodnie pisać w Pythonie: funkcje, klasy, list comprehension (NumPy mile widziany).
- Pamiętać mnożenie macierzy, logarytm i pojęcie pochodnej, resztę przypomnisz na szkoleniu.
- Mieć laptop z co najmniej 16 GB RAM i prawem do instalowania pakietów Pythona.
Czego się nauczysz?
- Zbudujesz od zera działający mały model językowy w PyTorch.
- Wytrenujesz model i odczytasz z wykresu straty, czy się uczy.
- Zrozumiesz, jak działa mechanizm uwagi i blok transformera.
- Wyjaśnisz, skąd biorą się halucynacje i jak wpływa na nie temperatura.
- Opiszesz drogę od małego modelu do LLM: pretrening, fine-tuning, dopasowanie i rozumowanie.
- Uruchomisz skwantyzowany otwarty model na własnym komputerze.
- Ocenisz, z czym model radzi sobie słabo przez samą budowę, np. z liczeniem liter.
Trener
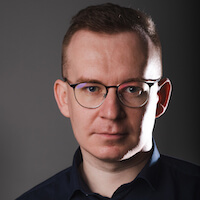
Piotr Kowalski
W branży IT od 2008 roku. Od 2014 jest mentorem dla wielu developerów. Jako trener spędził na sali szkoleniowej kilka tysięcy godzin, a na LinkedIn ma 52 rekomendacje. Każde jego szkolenie to dawka solidnej wiedzy oraz humoru.
Zorganizujmy to szkolenie w Twoim zespole
Napisz, z czym pracujecie i na jakim poziomie jest grupa. Odpowiem z propozycją programu dopasowanego do Waszego projektu.
Zapytaj o szkolenie Pobierz program (PDF) Zobacz wszystkie szkolenia